データセットの閲覧
thinkingface では、Parquet ファイルの行をダウンロードせずにブラウザ上で直接確認できます。このページでは、ファイルがビューア対象になる条件、ビューアの開き方、そしてビューアができること・できないことを説明します。コードを書く前にデータセットをざっと確認したい人向けの内容です。
ファイルがビューア対象になる条件
パスが .parquet で終わるファイルは、次にプッシュされた時点で自動的にインデックスされます。これはモデルリポジトリでもデータセットリポジトリでも同様です。手動の操作や設定は一切不要です — .parquet ファイルをプッシュすれば、それだけでビューアの対象になります。インデックスはデフォルトブランチに限りません — プッシュされたブランチに対して実行されるため、Viewer タブやビューアへのリンクは、インデックス済みの Parquet ファイルがあればデフォルト以外のブランチでも機能します。タグだけは例外で、タグへのプッシュやタグの作成ではインデックスジョブがスケジュールされません(タグに対する git push --delete もサーバーからは見えません)。そのため、タグにしか存在しない .parquet ファイルはビューア対象になりません — webhook 側の同じ制約については Webhooks を参照してください。
Arrow ファイルはインデックスされず、Web UI を使う で説明されている通常のファイルプレビューになります。CSV、TSV、JSON Lines ファイルも Parquet 用ビューアにはインデックスされませんが、10 MiB 未満であればファイルプレビュー自体の中で実際にソート可能なテーブルとして表示されます(単なるテキストへのフォールバックにはなりません)。見た目については Web UI を使う を参照してください。
プッシュした直後のリポジトリでは、サーバーがスキャンを完了するまでの間、一時的に「indexing」バナーが表示されることがあります。Viewer タブやファイルツリーのビューアリンクは、プッシュから数秒ほど遅れて反映される場合があります。
ビューアを開く
Parquet ファイルが 1 つでもインデックスされると、リポジトリページに Viewer タブが追加されます。このタブを開くか、ファイルツリーやファイル自身のプレビューにある「Open in viewer」をクリックすると、テーブルが読み込まれます:
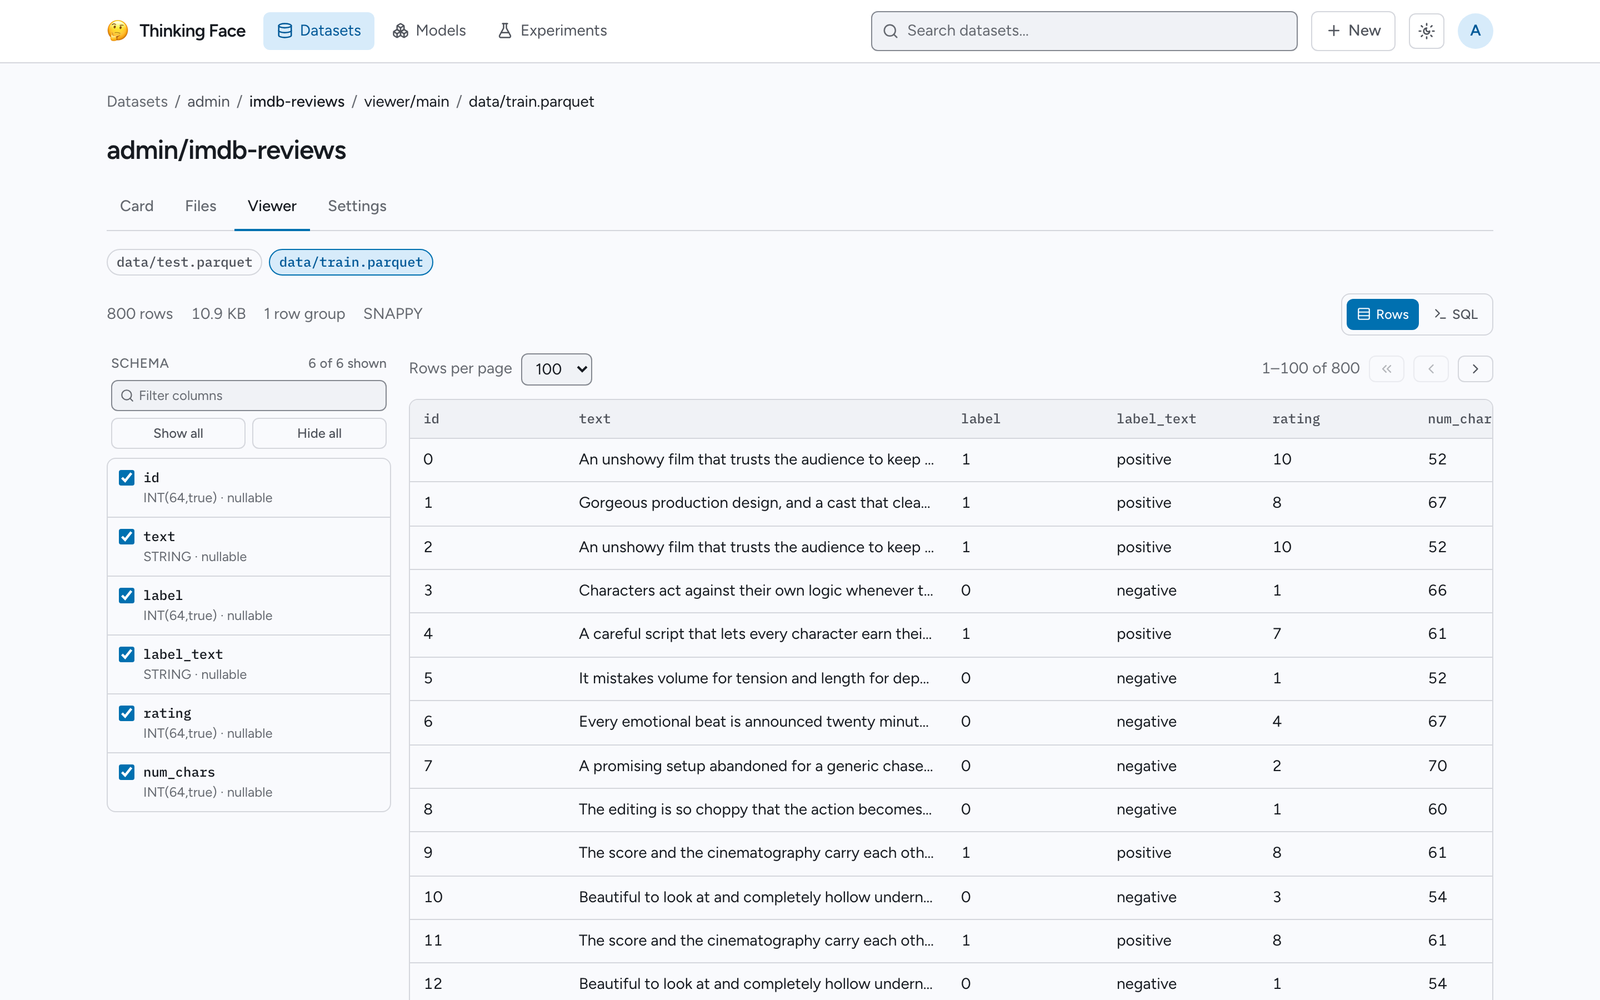
リポジトリにインデックス済みの Parquet ファイルが複数ある場合、テーブルの上に並ぶパスバッジをクリックしてファイルを切り替えられます。現在開いているファイルはハイライト表示されます。
表示される内容
テーブルの上のステータス行には、ファイルの総行数、サイズ、行グループ数、そして(ファイルに記録されている場合は)圧縮コーデックが表示されます。
左側のスキーマパネルには、すべてのカラムが論理型(論理型が適用されない場合は生の Parquet 型)、null 許容かどうか、繰り返しかどうかとともに一覧表示されます。さらに、サーバーが特定の種類のデータ(例えば画像や音声の feature)として認識しているカラムには、その feature の種類を示すバッジが付きます。フィルタボックスでカラム一覧を絞り込めるほか、「Show all」/「Hide all」ボタンで、フィルタが現在表示しているカラムの表示・非表示を切り替えられます。カラムを非表示にすると、単に表示から消えるだけでなく、取得・表示される行からも除外されます。
行をページ送りする
Rows タブは、テーブルを 50、100、200、500 行単位でページ送りします。先頭ページ、前のページ、次のページの操作ボタンが「X–Y of N」というカウンタの横に並びます。1 ページあたりの行数や表示するカラムを変更すると、先頭ページに戻ります。
ページ送りではファイル全体をダウンロードすることはありません。サーバーは、純粋な Go 実装の Parquet ライブラリ(CGo なし、外部プロセスなし)を使って、オブジェクトストレージ上の Parquet ファイルを直接読み取り、リクエストされたページの範囲に完全に含まれない行グループは丸ごとスキップします。そのため、数ギガバイトのファイルの 40 ページ目を開いても、1 ページ目を開くのとほぼ同じコストで済みます。サーバー上のローカルディスクキャッシュにより、同じファイルへの 2 回目以降のリクエストはさらに安く済みます。
SQL でクエリする
行数 / ページあたりの行数の操作の横にある SQL トグルに切り替えると、もう 1 つのモードになります。このモードでは、WebAssembly にコンパイルされた DuckDB を使い、ファイルに対して任意の SQL をブラウザ内だけで実行します — クエリはサーバーに届きません。最初に開いたとき、ブラウザはファイル全体をダウンロードするため、このモードには 500 MB のサイズ上限があります。それより大きいファイルの場合はその旨を説明するメッセージが表示され、Rows タブに戻るかファイルをダウンロードするよう案内されます。結果は 10,000 行までに制限され、CSV としてコピーして取り出せます。
実際の GCS(STORAGE_DRIVER=gcs)を使う本番デプロイでは、この最初のダウンロードはサーバーを経由せず、ブラウザから直接ストレージバケットに対して行われます。そのため、バケット自体がそれを許可するよう設定されている必要があります — 自分でストレージをセットアップする場合は デプロイ を参照してください。
ビューアができないこと
- 読み取り専用です。ビューアから行を編集したり、ファイルに書き戻したりする方法はありません。
- Parquet しか扱えません。基になっているデータが同等のものであっても、CSV、JSON Lines、Arrow IPC などの他の表形式のファイルを開くことはできません。
- Rows タブのカラムの表示・非表示やページ送りは、あくまで表示上の便宜であり、新しいファイルを作成したり、
hf_hub_download/git cloneが取得する内容を変えたりするものではありません。 - SQL モードの 500 MB という上限と、結果 10,000 行という上限は、ブラウザ内で DuckDB を動かすことによる固定的な制限であり、引き上げ可能なサーバー側の設定ではありません。